KI-Agenten absichern: Verifikation und Validierung nach dem V-Modell
Ein Entwickler lädt das Datenblatt eines Leistungs-MOSFET hoch und fragt den KI-Assistenten, wie viel Verlustleistung das Bauteil verträgt. Die Antwort: 139 W, mit Verweis auf die Tabelle der Grenzwerte. Die Zahl steht dort tatsächlich. Sie gilt aber nur bei 25 °C Gehäusetemperatur, also bei idealer Kühlung. Auf einer Leiterplatte mit 50 K/W bleiben laut derselben Tabelle 2,5 W. Zwischen beiden Werten liegt rund der Faktor 55, und die Antwort klingt in beiden Fällen gleich überzeugend.
Das ist der Normalfall, nicht die Ausnahme. Solange KI nur Texte vorschlägt, landet ein solcher Fehler in einem Entwurf. Sobald ein Agent selbst Werkzeuge bedient, Dateien ändert oder Freigaben setzt, landet er im Prozess. Die gute Nachricht für Entwicklungsorganisationen: Das Handwerkszeug für diese Lage ist vorhanden. Es heißt Verifikation und Validierung.
Plausibel ist kein Prüfkriterium
Drei Befunde zeigen, warum der Eindruck einer Antwort nichts über ihre Richtigkeit sagt.
- Quellenanbindung reicht nicht. Juristische Recherchewerkzeuge mit angebundener Fachdatenbank lieferten in einer vorregistrierten Stanford-Studie bei 17 bis 33 % der Anfragen falsche oder falsch belegte Aussagen (Magesh et al. 2025).
- Gleiche Frage, andere Antwort. 1.000 identische Anfragen bei Temperatur 0 ergaben 80 verschiedene Antworten, die häufigste kam nur 78-mal. Ursache ist die wechselnde Bündelung von Anfragen auf dem Server, nicht das Modell selbst (He / Thinking Machines Lab 2025). Ein einzelner Testlauf beweist also nichts.
- Die Anwender wissen es. Im Stack Overflow Developer Survey 2026 (30.903 Antworten) würden nur 6,6 % der Befragten KI-Ergebnissen bei wichtigen Entscheidungen vertrauen. 48 % vertrauen ihnen, wenn sie das Ergebnis leicht nachprüfen können.
Der letzte Punkt beschreibt die Aufgabe: Vertrauen entsteht über Prüfbarkeit.
Vom Assistenten zum Agenten: Fehler multiplizieren sich
Ein Agent arbeitet in vielen Schritten. Er ruft Werkzeuge auf, verändert Zustände und baut auf Zwischenergebnissen auf. Damit gelten zwei einfache Rechnungen.
- Kettenlänge: Gelingt jeder Schritt mit 95 %, gelingt eine Kette aus zehn Schritten nur in 60 % der Fälle.
- Wiederholbarkeit: Im Benchmark τ-bench löste ein Agent rund 61 % der Kundendienst-Aufgaben im ersten Versuch. Verlangt man, dass dieselbe Aufgabe achtmal hintereinander gelingt, bleiben rund 25 % (Yao et al. 2025).
Eine Princeton-Gruppe hat diese Lücke 2026 systematisch vermessen. Die Ergebniskonsistenz der untersuchten Agenten lag zwischen 30 und 75 %, und der Zuwachs an Fähigkeit hat die Zuverlässigkeit kaum mitgezogen (Rabanser et al. 2026).
Was das im Betrieb heißt, zeigte ein Vorfall im April 2026. Nach Darstellung des Gründers löschte ein Coding-Agent bei einem SaaS-Anbieter die Produktionsdatenbank samt Backups in neun Sekunden, während er eigentlich an der Testumgebung arbeitete. Die Regel, genau das nicht zu tun, stand in den Anweisungen. Der Zugangsschlüssel mit den nötigen Rechten lag trotzdem in Reichweite. Die Daten ließen sich später wiederherstellen, die Lehre bleibt.
Das V-Modell passt – sinngemäß
Verifikation fragt: Ist es richtig gebaut, gemessen an Spezifikation und Quelle? Validierung fragt: Ist das Richtige gebaut, gemessen am Bedarf im Einsatz? Beides gilt für Agenten unverändert. Ein Agent kann den korrekten Normwert liefern, während das Projekt den strengeren Werkstandard verlangt. Dann ist die Antwort verifiziert und trotzdem falsch.
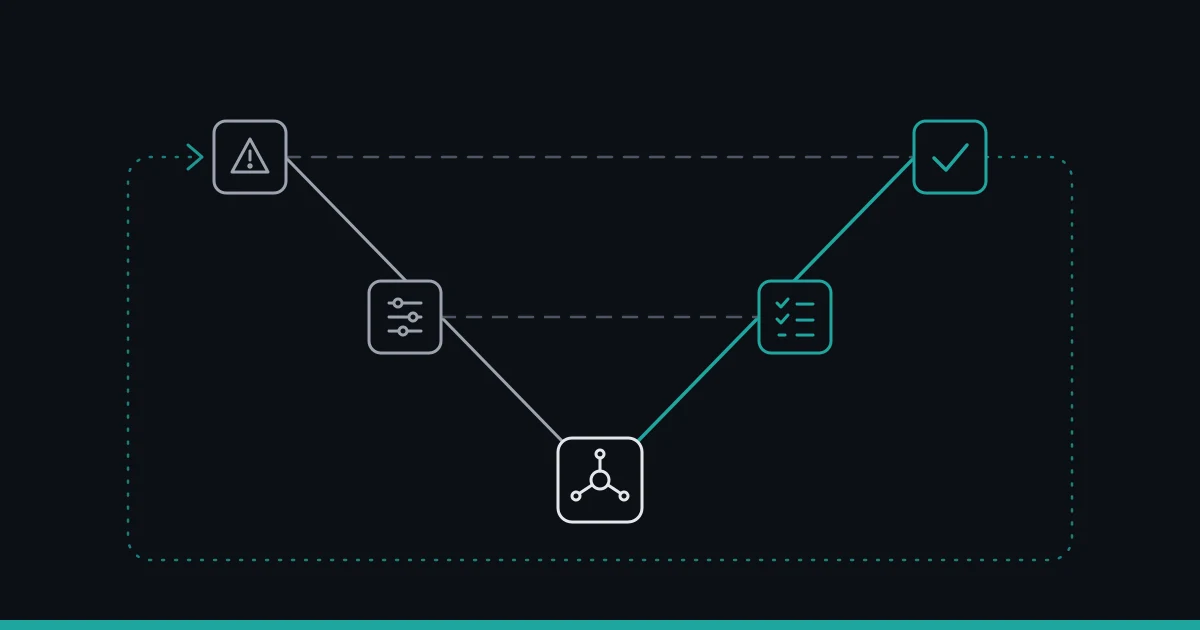
Aus dieser Logik ergeben sich fünf Stationen. Links im V wird geplant, rechts nachgewiesen, und der Betrieb schließt den Kreis – so zeigt es auch das Titelbild.
Station 1: Risiko einordnen
Zwei Fragen entscheiden über den gesamten Aufwand: Liest der Agent nur, oder handelt er? Und wie schwer wiegt ein Fehler?
| Fehlerfolge gering | Fehlerfolge hoch | |
|---|---|---|
| KI liest | Wissensassistent, z. B. Normkapitel nachschlagen. Quellenpflicht und Stichproben genügen. | Entscheidungsunterstützung, z. B. Datenblattwert für die Auslegung. Testkatalog, Freigabe, benannter Verantwortlicher. |
| KI handelt | Rücknehmbare Automatisierung, z. B. Entwürfe anlegen. Aktionen begrenzen und protokollieren. | Autonomer Agent, z. B. versenden, freigeben, löschen. Alle Absicherungen, technisch erzwungen. |
Station 2: Hebel festlegen
Vier Hebel stehen zur Wahl. Jeder beantwortet eine Frage.
- Attestation – wer ist der Agent? Version, Wissensquellen, Eigentümer. Innerhalb einer Plattform übernimmt das meist deren Identitätsverwaltung. Übergreifende Standards entstehen erst, etwa in der AI Agent Standards Initiative des NIST seit Februar 2026.
- Guardrails – darf er das? Feste Grenzen für Quellen und Aktionen, durchgesetzt über Berechtigungen und nicht über Formulierungen. Die OWASP-Liste für agentische Anwendungen führt Werkzeugmissbrauch als eigenes Risiko und empfiehlt, jedem Agenten nur die Handlungsfähigkeit zu geben, die er braucht.
- Evaluierung – stimmt es? Systematische Tests gegen Soll-Ergebnisse, erneut nach jeder Änderung an Prompt, Quellen oder Modell.
- Governance – wer verantwortet? Ein benannter Eigentümer und eine Freigaberegel. Ein kanadisches Tribunal hat 2024 das Argument einer Fluggesellschaft abgewiesen, ihr Chatbot sei für seine Auskünfte selbst verantwortlich.
Nicht jeder Agent braucht alle vier. Ein rein lesender Agent auf eigenen Dokumenten braucht vor allem Evaluierung und Governance. Wer hier Sicherheitsarchitektur aufbaut, verschwendet Aufwand, der bei den Tests fehlt.
Station 3: Verifizieren mit einem Golden Set
Ein Golden Set ist der Prüfplan des Agenten: ein fester Katalog aus Aufgabe, Soll-Ergebnis und Fundstelle. Vier Regeln machen ihn belastbar.
- Drei Fragetypen. Standardfälle aus dem Alltag, Grenzfälle mit Bedingungen, Fußnoten und Einheiten sowie Fangfragen, deren Antwort nicht in den Quellen steht. Das Soll lautet dann „nicht enthalten“. Fangfragen sind kein Beiwerk: Sprachmodelle raten, weil Training und Bewertung das Raten belohnen und das Eingeständnis von Unsicherheit bestrafen (Kalai et al. 2025).
- Aus echten Fehlern speisen. 20 bis 50 Aufgaben aus tatsächlich beobachteten Fehlern sind ein tragfähiger Anfang (Anthropic 2026).
- Ergebnis prüfen, nicht Behauptung. Bei handelnden Agenten zählt der Endzustand im System. Die Buchung muss in der Datenbank stehen, die Aussage „gebucht“ genügt nicht.
- Mehrfach laufen lassen. Jede Aufgabe wird mehrmals gestellt und gilt nur als bestanden, wenn alle Läufe gelingen. Bei 75 % Einzelerfolg gelingen drei Läufe in Folge nur in 42 % der Fälle.
Bleibt die Frage, was ein bestandener Test wert ist. Angenommen, die Freigabeschwelle liegt bei 90 % richtigen Antworten.
- Ein Agent mit real 85 % besteht einen Test mit 25 Fragen trotzdem in jedem vierten Durchlauf. Bei 100 Fragen gelingt ihm das noch in jedem zehnten.
- Null Fehler bei zehn Fangfragen bedeuten nur, dass keiner gefunden wurde. Die tatsächliche Fehlerrate kann mit 95 % Sicherheit bis zu 26 % betragen. Als Faustregel gilt 3 geteilt durch die Zahl der Fragen (Hanley & Lippman-Hand 1983).
Station 4: Validieren und nutzen
Vor der Einführung steht ein Pilot mit echten Nutzern. Das Kriterium ist der Bedarf: Wird die Aufgabe schneller und vollständiger erledigt? Im Einsatz prüft dann der Mensch, abgestuft nach Fehlerfolge.
- Inspiration (Ideen, Gliederung): Plausibilität, Sekunden.
- Arbeitsergebnis (Bericht, Zusammenfassung): Kernaussagen gegen die Quelle, Zahlen nachrechnen, Minuten.
- Entscheidungsgrundlage (Normwerte, Bauteilwerte, Freigaben): Primärquelle selbst lesen, Vier-Augen-Prinzip. Der Prüfaufwand bleibt wie ohne KI, der Gewinn liegt im Finden der Stelle.
Drei Handgriffe decken die meisten plausiblen Fehler auf: Fundstelle öffnen, nach der Bedingung fragen, Größenordnung gegenrechnen. Beim MOSFET aus dem Einstieg genügt der dritte: (150 − 25) K ÷ 50 K/W = 2,5 W.
Diese Station hat eine bekannte Schwäche, und sie sitzt beim Menschen. Je verlässlicher ein System wirkt, desto weniger wird es geprüft (Parasuraman & Manzey 2010). Eine Befragung von 319 Wissensarbeitern fand denselben Zusammenhang für generative KI: Mehr Vertrauen in das Werkzeug ging mit weniger kritischer Prüfung einher (Lee et al. 2025). Die KI-Verordnung nennt diesen Automatisierungsbias in Art. 14 Abs. 4 Buchst. b ausdrücklich. Eine Freigabe durch den Menschen wirkt nur, wenn sie eine Prüfung ist und kein Klick.
Station 5: Betreiben
Keine Station ist dicht. Jede fängt einen Teil der Fehler, erst die Schichtung macht das System tragfähig. Den Rest erledigt ein Regelkreis:
- Der Agent liefert ein Ergebnis mit Fundstelle oder Protokoll.
- Der Mensch prüft nach Prüftiefe und gibt frei.
- Fehler aus dem Feld gehen an den Eigentümer.
- Jeder Feldfehler wird ein Testfall im Golden Set. Die nächste Version geht erst in Betrieb, wenn sie ihn besteht.
Fehler lassen sich nicht ausschließen. Erreichbar ist, dass jeder nur einmal passiert.
Was Normen und Regulierung heute hergeben
- Funktionale Sicherheit: Fehler von Sprachmodellen sind selten Fehlfunktionen im Sinn der ISO 26262. Sie sind unzureichende Leistung und stehen damit der SOTIF-Logik (ISO 21448) näher. ISO/PAS 8800:2024 ergänzt beide um KI-spezifische Anforderungen für Straßenfahrzeuge.
- Unabhängigkeit: Das Muster „komplexe Funktion, einfacher unabhängiger Monitor“ trägt auch hier. Prüft dasselbe Sprachmodell seine eigene Antwort, ist das kein unabhängiger Monitor. Unabhängig sind deterministischer Code oder der Mensch.
- KI-Verordnung: Die Hochrisiko-Pflichten gelten nach der Änderungsverordnung (EU) 2026/1744 ab dem 2. Dezember 2027 für Anhang III und ab dem 2. August 2028 für KI in regulierten Produkten nach Anhang I. Die meisten internen Entwicklungsagenten dürften nicht darunter fallen. Die geforderte Logik aus Risikoeinstufung, Genauigkeitsnachweis, menschlicher Aufsicht und Protokollierung entspricht aber den fünf Stationen. Die Einordnung dazu steht im Artikel zum EU AI Act für Industrieunternehmen.
Eine Norm, die vorgibt, wie ein Agent zu verifizieren ist, gibt es bisher nicht. Wer Schwellen wie „90 % und null Fehler bei Fangfragen“ festlegt, trifft eine eigene Festlegung und sollte sie so benennen. Rechtsberatung ist dieser Artikel nicht.
Weitere Artikel
Fünf Fragen für das eigene Vorhaben
- Liest oder handelt der Agent, und was passiert, wenn er falsch liegt?
- Welche der vier Hebel sind nötig, welche wären überzogen?
- Gibt es 20 bis 30 Testaufgaben mit Soll-Ergebnis, darunter Fangfragen, und laufen sie nach jeder Änderung erneut?
- Prüft ein Mensch mit Fundstelle, in einer Tiefe, die zur Fehlerfolge passt?
- Wohin gehen Fehler aus dem Betrieb, und wer pflegt den Testkatalog?
Wer diese fünf Fragen schriftlich beantworten kann, hat einen Absicherungsnachweis. Wer es nicht kann, hat einen Agenten, der bisher Glück hatte.
Genau an diesen fünf Fragen setze ich an – als unabhängiges technisches Review eines geplanten oder laufenden Agenten (Risikoeinstufung, Testkatalog, Freigaberegel) oder in der Prozessautomatisierung, wenn der Agent erst entsteht.
Quellen
Anthropic (2026): Demystifying evals for AI agents · Hanley & Lippman-Hand (1983): If Nothing Goes Wrong, Is Everything All Right? JAMA 249(13) · He / Thinking Machines Lab (2025): Defeating Nondeterminism in LLM Inference · Infineon: BSC010N04LSI, Datenblatt, Maximum ratings · ISO 26262:2018, ISO 21448:2022, ISO/PAS 8800:2024 · Kalai et al. (2025): Why Language Models Hallucinate, arXiv:2509.04664 · Lee et al. (2025): The Impact of Generative AI on Critical Thinking, CHI 2025 · Magesh et al. (2025): Hallucination-Free? Journal of Empirical Legal Studies 22(2) · MIT AI Incident Tracker, Incident 1469 (PocketOS, 2026) · Moffatt v. Air Canada, 2024 BCCRT 149 · NIST CAISI (2026): AI Agent Standards Initiative · OWASP (2025): Top 10 for Agentic Applications 2026 · Parasuraman & Manzey (2010): Complacency and Bias in Human Use of Automation, Human Factors 52(3) · Rabanser et al. (2026): Towards a Science of AI Agent Reliability, ICML 2026 · Stack Overflow (2026): Developer Survey 2026 · Verordnung (EU) 2024/1689, Art. 14; Verordnung (EU) 2026/1744 · Yao et al. (2025): τ-bench, ICLR 2025
Damit das Review die richtige Antwort liefert – nicht nur eine zweite Meinung.
PDF öffnenKI-Agent geplant – oder schon im Einsatz?
Bringen Sie Anwendungsfall und Wissensquellen mit – im Erstgespräch ordnen wir das Risiko ein und klären, welche Absicherung nötig ist und welche nicht. Kostenlos, 45 Minuten, ohne Verkaufsabsicht.
Erstgespräch buchenMehr zur Leistung: Prozessautomatisierung & Digitalisierung →